コード
import pandas as pd

data = {
    "store": ["A", "B", "C", "D", "E", "F"],
    "employees": [2, 3, 3, 4, 2, 5],
    "sales": [1, 3, 2, 3, 2, 2],
}
df = pd.DataFrame(data)
df["ratio"] = df["sales"] / df["employees"]データ包絡分析(DEA: Data Envelopment Analysis)は,入力と出力のデータに基づいて,分析対象の相対的な効率性を評価する手法である(Charnes ほか 1978年).DEAでは,分析対象となる組織や事業体などをDMU(Decision Making Unit,意思決定単位)と呼ぶ.各DMUを,人員や設備などの資源である入力(input)を用いて,製品やサービスなどの成果である出力(output)を生み出すものと捉える.入力と出力は,それぞれ1つでも複数でもよい.比較にあたっては,類似した活動を行うDMUを対象とし,共通の入力・出力指標を用いる.
表 4.1 に,DMUと入力・出力の例を示す.例えば,店舗を対象とする場合は,店舗同士の効率性を比較する.
| DMU | 入力 | 出力 |
|---|---|---|
| 店舗 | 店員数,店舗面積 | 売上高,顧客数 |
| 大学 | 教員数,研究費 | 卒業生数,論文数,特許数 |
| 病院 | 医師数,看護師数,病床数 | 外来患者数,退院患者数,手術件数 |
n 個のDMUがあり,各 \text{DMU}_j (j=1,2,\ldots,n) は,1 つの入力 x_j > 0 と 1 つの出力 y_j を持つとする.このとき,\text{DMU}_j の効率性は,入力に対する出力の比
\frac{y_j}{x_j}
で評価できる.この比は,単位入力あたりの出力を表し,値が大きいほど効率がよい.比較対象となる n 個の DMU のうち,この比が最大となる DMU は効率的(efficient)であるという.
例 4.1 (1 入力 1 出力の問題例) ある会社が運営する 6 つの店舗について,店員数と月間売上高を 表 4.2 に示す.店員数を入力,売上高を出力とし,売上高を店員数で割った値を用いて,各店舗の効率性を比較する.
| 店舗 | A | B | C | D | E | F |
|---|---|---|---|---|---|---|
| 店員数(人) | 2 | 3 | 3 | 4 | 2 | 5 |
| 月間売上高(百万円) | 1 | 3 | 2 | 3 | 2 | 2 |
店舗 j の店員数を x_j,月間売上高を y_j とすると,その効率性は y_j/x_j で評価できる.この比は,店員 1 人あたりの月間売上高を表す.各店舗について計算すると,表 4.3 のようになる.
import pandas as pd
data = {
"store": ["A", "B", "C", "D", "E", "F"],
"employees": [2, 3, 3, 4, 2, 5],
"sales": [1, 3, 2, 3, 2, 2],
}
df = pd.DataFrame(data)
df["ratio"] = df["sales"] / df["employees"]| 店舗 | A | B | C | D | E | F |
|---|---|---|---|---|---|---|
| y_j/x_j | 1/2 | 1 | 2/3 | 3/4 | 1 | 2/5 |
この比が最大となるのは店舗 B と E であり,いずれも店員 1 人あたりの月間売上高は 100 万円である.したがって,比較対象の 6 店舗のうち,B と E が効率的である.両店舗は店員数も売上高も異なるが,効率性は等しい.
図 4.1 は,横軸に店員数,縦軸に月間売上高をとり,各店舗を点 (x_j, y_j) として示したものである.
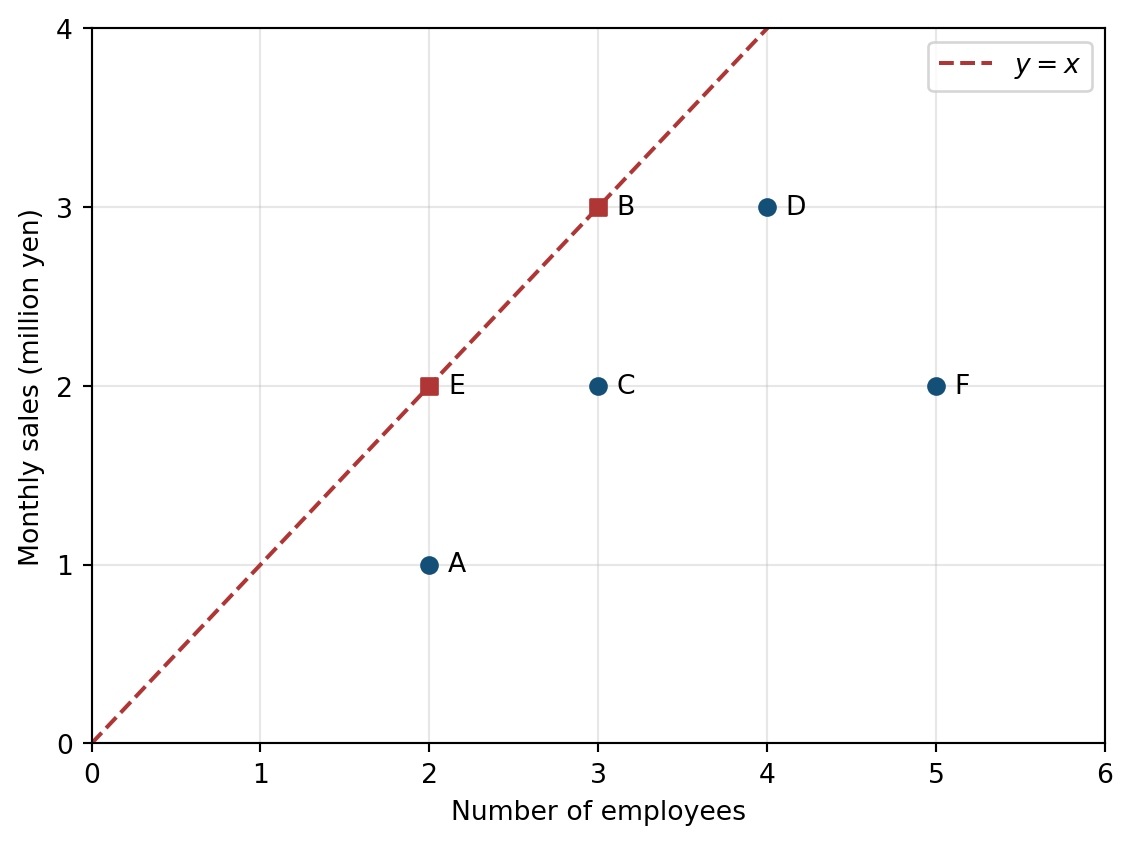
図中の破線は,原点と店舗 B,E を通る直線 y=x である.店舗 B と E はこの直線上にあり,それ以外の店舗はすべて直線の下側に位置している.
ここでは,ある入力と出力の組合せが実現可能ならば,入力と出力を同じ正の倍率で拡大・縮小した組合せも実現可能であると仮定する.この仮定を規模に関する収穫一定(constant returns to scale)という.例えば,店舗 E の入力と出力をともに 1.5 倍すると,店舗 B と同じ組合せになる.
この例で見た効率性と直線の傾きの関係を,一般の場合について考える.横軸に入力,縦軸に出力をとり,各 DMU を点 (x_j, y_j) としてプロットすると,原点と各点を結ぶ直線の傾きは y_j/x_j に等しい.つまり,この直線の傾きが大きいほど,その DMU の効率性は高い.
原点と効率的な DMU を結ぶ直線は,これらの直線の中で傾きが最も大きく,すべての DMU の点はこの直線上またはその下側に位置する.この直線を効率的フロンティア(efficient frontier)と呼ぶ.先ほどの例では,店舗 B と E を通る直線 y=x が効率的フロンティアにあたる.
次に,各 \text{DMU}_j が 2 つの入力 x_{1j}, x_{2j} と 1 つの出力 y_j > 0 を持つ場合を考える.例えば,店舗の店員数と面積を入力,売上高を出力とする場合である.
店舗ごとに売上高が異なるため,店員数や面積をそのまま比べるだけでは,効率性を判断しにくい.規模に関する収穫一定の仮定のもとでは,各 DMU の入力と出力をともに 1/y_j 倍し,出力を 1 単位にそろえることができる.そこで,出力 1 単位あたりに必要な入力量
\frac{x_{1j}}{y_j},\quad \frac{x_{2j}}{y_j}
を比較する.店舗の例では,売上高 1 単位を得るために必要な店員数と面積を表す.どちらの値も,小さいほど少ない入力で同じ量の出力を得られることを意味する.
横軸に第 1 の入力と出力の比,縦軸に第 2 の入力と出力の比をとり,各 DMU を点
P_j = \left(\frac{x_{1j}}{y_j},\ \frac{x_{2j}}{y_j}\right)
としてプロットする.図では,左にあるほど第 1 の入力が少なく,下にあるほど第 2 の入力が少ない.次の例で,点の位置と効率性の関係を見てみよう.
例 4.2 (2 入力 1 出力の問題例) ある会社が運営する 6 つの店舗について,店員数,面積,売上高を 表 4.4 に示す.店員数と面積を入力,売上高を出力とし,どの店舗が効率的かを考える.
| 店舗 | A | B | C | D | E | F |
|---|---|---|---|---|---|---|
| 店員数(x_1) | 4 | 7 | 8 | 4 | 2 | 5 |
| 面積(x_2) | 3 | 3 | 1 | 2 | 4 | 2 |
| 売上高(y) | 1 | 1 | 1 | 1 | 1 | 1 |
すべての店舗の売上高は 1 であるため,ここでは店員数と面積をそのまま比較できる.同じ売上高を得るとき,どちらの入力も多くなく,少なくとも一方の入力が少ない店舗があれば,その店舗のほうが効率がよいと考える.
例えば,店舗 A と D を比べると,店員数は同じであるが,D のほうが面積は小さい.また,D は B より店員数が少なく,面積も小さい.F と比べても,同じ面積で店員数が少ない.したがって,A,B,F は非効率的である.
図 4.2 は,横軸に売上高 1 単位あたりの店員数,縦軸に売上高 1 単位あたりの面積をとり,各店舗の位置を示したものである.
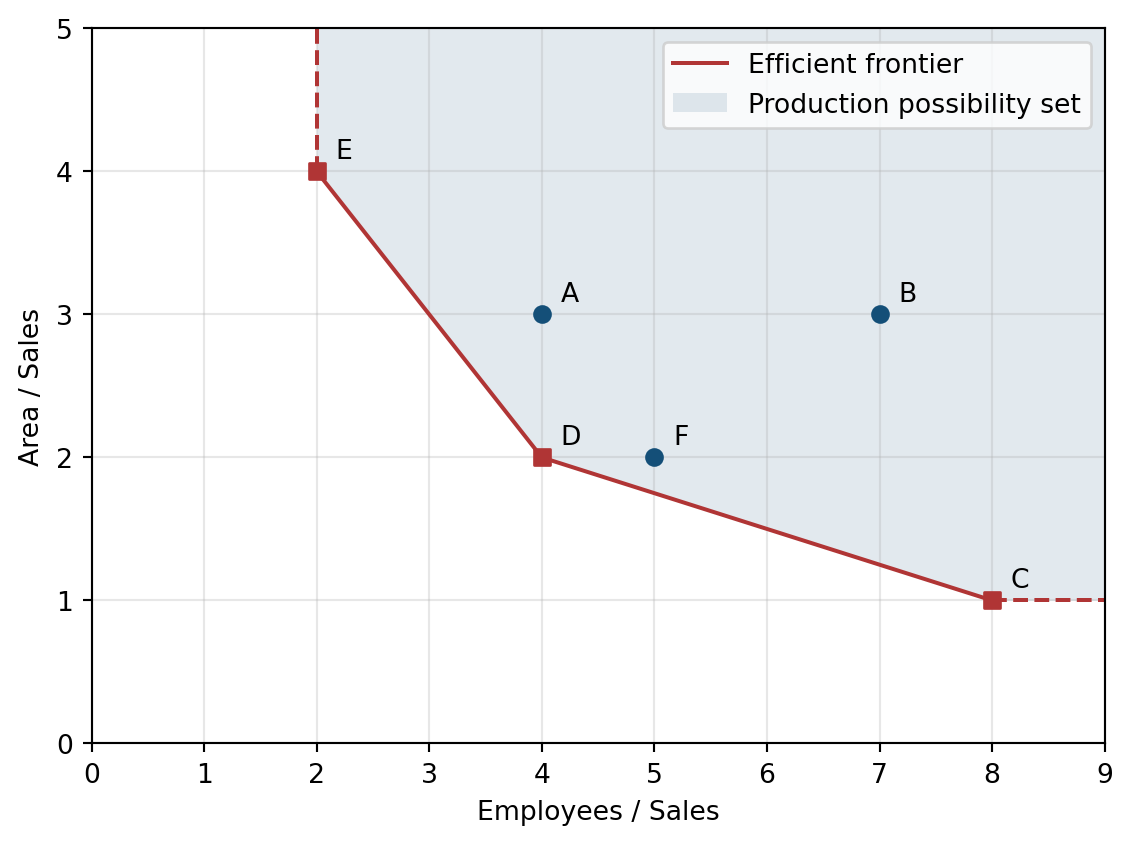
次に,実際に観測された店舗だけでなく,それらを組み合わせた仮想的な店舗も比較の対象に加える.観測された DMU の入力と出力を共通の重みで組み合わせて構成したものを,仮想的な DMU(virtual DMU)と呼ぶ.ここでは,重みを非負とし,その合計を 1 とする.この加重平均で得られる組合せも,実現可能であると仮定する.
例えば,D と E をそれぞれ 1/2 の重みで組み合わせると,店員数は (4+2)/2=3,面積は (2+4)/2=3,売上高は (1+1)/2=1 となる.この仮想的な店舗を表す点 Q=(3,3) は,線分 P_DP_E の中点に位置する.より一般に,D と E の重みをそれぞれ w,1-w とすると,対応する点は
wP_D+(1-w)P_E,\qquad 0\le w\le 1
と表される.重み w を変えると,線分 P_DP_E 上のすべての点が得られる.このように,線分上の点は,両端の店舗を組み合わせた仮想的な DMU に対応する.同じ考え方を,ほかの店舗の組合せにも適用する.
さらに,ある入力の組合せで売上高 1 を実現できるならば,どちらの入力も減らさず,一方または両方を増やした組合せでも,同じ売上高を実現できると仮定する.図では,実現可能な点から右または上に移動した点も,実現可能であることを意味する.
これらの仮定のもとで,売上高 1 を実現できるとみなす入力の組合せ全体を考えると,折れ線 P_EP_DP_C と,E から上に延ばした鉛直な半直線,C から右に延ばした水平な半直線を境界として,その右上側に広がる領域が得られる.境界もこの領域に含まれる.これを,生産可能集合(production possibility set)と呼ぶ.図の薄い青色の領域は,生産可能集合を表す.
この領域の中で,折れ線 P_EP_DP_C 上の点から一方の入力を減らすには,もう一方の入力を増やさなければならない.つまり,仮想的な店舗も含めて比較しても,この折れ線上の点より,どちらの入力も多くなく,少なくとも一方の入力が少ない点は存在しない.この折れ線を効率的フロンティアと呼ぶ.店舗 C,D,E はこの上に位置するため,効率的である.
この例で見た考え方を,一般の 2 入力 1 出力の場合にまとめよう.出力量が異なる場合は,規模に関する収穫一定の仮定に基づいて,まず出力を 1 単位にそろえる.そのうえで,例と同様に,加重平均による組合せと,出力を保ったまま入力を増やした組合せも実現可能であると仮定し,生産可能集合を考える.
出力を 1 単位にそろえた生産可能集合の中に,両方の入力量がそれぞれ x_{1j}/y_j,x_{2j}/y_j 以下で,少なくとも一方がより小さい点が存在するとき,\text{DMU}_j は非効率的である.そのような点が存在しなければ,\text{DMU}_j は効率的である.この意味で効率的な点の集合が,効率的フロンティアである.
次に,\text{DMU}_j が 1 つの入力 x_j > 0 と 2 つの出力 y_{1j}, y_{2j} を持つ場合を考える.2 入力 1 出力の場合と同様に,入力と出力の比を用いて各 DMU を比較する.ここでは,入力を 1 単位にそろえ,2 つの出力量
\frac{y_{1j}}{x_j},\quad \frac{y_{2j}}{x_j}
に着目する.これらの値は,大きいほど望ましい.入力を 1 単位にそろえた生産可能集合の中に,両方の出力量がそれぞれ y_{1j}/x_j,y_{2j}/x_j 以上で,少なくとも一方がより大きい点が存在するとき,\text{DMU}_j は非効率的である.そのような点が存在しないとき,\text{DMU}_j は効率的である.したがって,効率的な DMU は,生産可能集合の右上側にある効率的フロンティア上に位置する.
例 4.3 (1 入力 2 出力の問題例) ある会社が運営する 6 つの店舗について,店員数,売上高,顧客数を 表 4.5 に示す.店員数を入力,売上高と顧客数を出力とし,どの店舗が効率的かを考える.
| 店舗 | A | B | C | D | E | F |
|---|---|---|---|---|---|---|
| 店員数(x) | 1 | 1 | 1 | 1 | 1 | 1 |
| 売上高(y_1) | 1 | 2 | 3 | 4 | 4 | 6 |
| 顧客数(y_2) | 5 | 7 | 4 | 3 | 6 | 2 |
店舗 j の店員数を x_j,売上高を y_{1j},顧客数を y_{2j} とする.各店舗を比較するために,店員 1 人あたりの売上高 y_{1j}/x_j と顧客数 y_{2j}/x_j に着目する.
図 4.3 は,横軸に店員 1 人あたりの売上高,縦軸に店員 1 人あたりの顧客数をとり,各店舗の位置を示したものである.右にあるほど売上高が大きく,上にあるほど顧客数が多い.
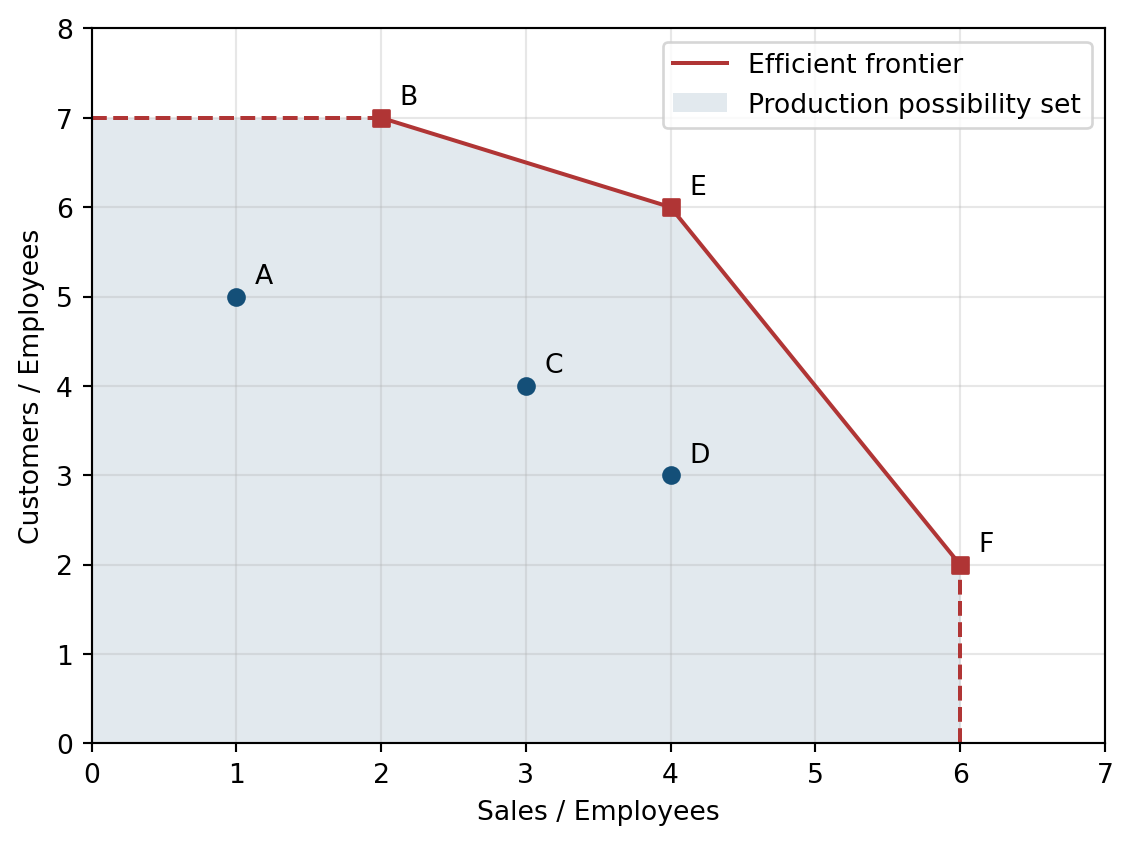
図の薄い青色の領域は,入力を 1 単位にそろえた生産可能集合を表す.この集合の中には,B,E,F のいずれに対しても,一方の出力を減らさずに他方を増やせる点は存在しない.したがって,B,E,F は効率的であり,これらを順に結ぶ赤い折れ線が効率的フロンティアとなる.
練習 4.1 (1 入力 1 出力) 表 4.6 に,5 つの DMU の入力と出力を示す.出力を入力で割った比を用いて,効率的な DMU を求めよ.また,比の最大値を基準として,各 DMU の効率性を [0,1] の範囲で評価せよ.
| DMU | A | B | C | D | E |
|---|---|---|---|---|---|
| 入力 | 4 | 7 | 8 | 5 | 6 |
| 出力 | 2 | 7 | 9 | 4 | 5 |
練習 4.2 (2 入力 1 出力) 表 4.7 に,5 つの DMU の入力と出力を示す.各入力を出力で割った比を用いて散布図を描き,効率的な DMU を求めよ.
| DMU | A | B | C | D | E |
|---|---|---|---|---|---|
| 入力 1 | 6 | 6 | 12 | 4 | 15 |
| 入力 2 | 4 | 12 | 9 | 8 | 5 |
| 出力 | 2 | 6 | 3 | 2 | 5 |