from scipy.stats import rv_discrete

X_values = [1, 2, 3, 4, 5, 6]
X_probs = [1 / 6, 1 / 6, 1 / 6, 1 / 6, 1 / 6, 1 / 6]

X = rv_discrete(values=(X_values, X_probs))付録 D — 確率統計
試行で起こりうる結果全体の集合を標本空間(sample space)と呼び,\Omega と書く.確率変数(random variable)は,試行の各結果に実数を対応させる関数であり,X: \Omega \to \mathbb{R} と表せる.一般に,確率変数は大文字の X, Y などで表される.確率変数 X が取りうる値の集合を X の値域と呼び,X(\Omega) と書く.
例 D.1 サイコロを 1 回投げる試行では,標本空間を \Omega = \{1, 2, 3, 4, 5, 6\} とできる.出た目を表す確率変数 X は,各結果 \omega \in \Omega に対して X(\omega) = \omega と定義される.この例では,X の値域 X(\Omega) = \{1, 2, 3, 4, 5, 6\} は標本空間と一致する.
例 D.2 例 D.1 と同じ試行で,偶数の目が出たかどうかを表す確率変数 Y を次のように定義する.
Y(\omega) = \begin{cases} 1 & (\omega \text{ が偶数}) \\ 0 & (\omega \text{ が奇数}) \end{cases}
試行の結果 \omega と,確率変数 X,Y の値の対応を次の表に示す.
| 試行の結果 \omega | 出た目 X(\omega) | 偶数かどうか Y(\omega) |
|---|---|---|
| 1 | 1 | 0 |
| 2 | 2 | 1 |
| 3 | 3 | 0 |
| 4 | 4 | 1 |
| 5 | 5 | 0 |
| 6 | 6 | 1 |
このとき,標本空間とそれぞれの確率変数の値域は次のようになる.
\begin{aligned} \Omega &= \{1, 2, 3, 4, 5, 6\}, \\ X(\Omega) &= \{1, 2, 3, 4, 5, 6\}, \\ Y(\Omega) &= \{0, 1\}. \end{aligned}
本章では,離散型(discrete)と連続型(continuous)の確率変数を取り上げる.
D.1 離散型確率変数
確率質量関数(probability mass function; PMF)は,離散型確率変数が特定の値を取る確率を表す関数であり,f(x) = P(X = x) と書く.
scipy.stats モジュールを用いて,離散型確率変数を定義できる.
この確率変数 X の確率質量関数を 図 D.1 に示す.
コード
import matplotlib.pyplot as plt

plt.rcParams["mathtext.fontset"] = "cm"

x = X_values
y = X.pmf(x)

plt.figure(figsize=(6, 3.6))
plt.stem(x, y, linefmt="#2c5f8a", markerfmt="o", basefmt=" ")
plt.xlabel("$x$")
plt.ylabel("$P(X = x)$")
plt.ylim(0, 0.2)
plt.yticks([0, 1 / 6], ["0", "1/6"])
plt.grid(axis="y", alpha=0.3)
plt.show()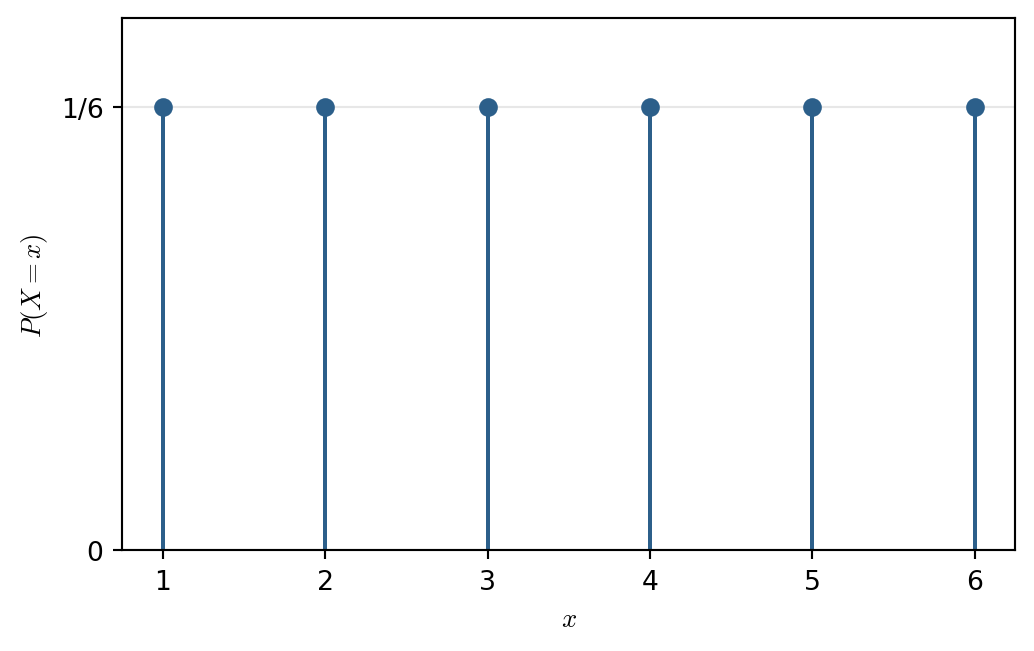
例えば,P(X = 3) を計算するには,次のようにする.
print(X.pmf(3))0.16666666666666666累積分布関数(cumulative distribution function; CDF)は,確率変数が特定の値以下を取る確率を表す関数であり,F(x) = P(X \leq x) と書く.
累積分布関数を 図 D.2 に示す.
コード
import numpy as np

x = np.arange(1, 7)
y_cdf = X.cdf(x)

plt.figure(figsize=(6, 3.6))
# x < 1 では F(x) = 0
plt.hlines(0, 0, x[0], colors="#2c5f8a")
plt.scatter(x[0], 0, color="white", edgecolor="#2c5f8a", zorder=3)
# 1 ≤ x < 6 では,次の目に達するまで値は一定
for i in range(len(x) - 1):
    plt.hlines(y_cdf[i], x[i], x[i + 1], colors="#2c5f8a")
    plt.scatter(x[i + 1], y_cdf[i], color="white", edgecolor="#2c5f8a", zorder=3)
# x ≥ 6 では F(x) = 1
plt.hlines(y_cdf[-1], x[-1], 7, colors="#2c5f8a")
# 各目での値
plt.scatter(x, y_cdf, color="#2c5f8a", zorder=3)
plt.xlabel("$x$")
plt.ylabel("$P(X \\leq x)$")
plt.xlim(0, 7)
plt.ylim(-0.05, 1.1)
plt.yticks(
    [0, 1 / 6, 2 / 6, 3 / 6, 4 / 6, 5 / 6, 1],
    ["0", "1/6", "2/6", "3/6", "4/6", "5/6", "1"],
)
plt.grid(alpha=0.3)
plt.show()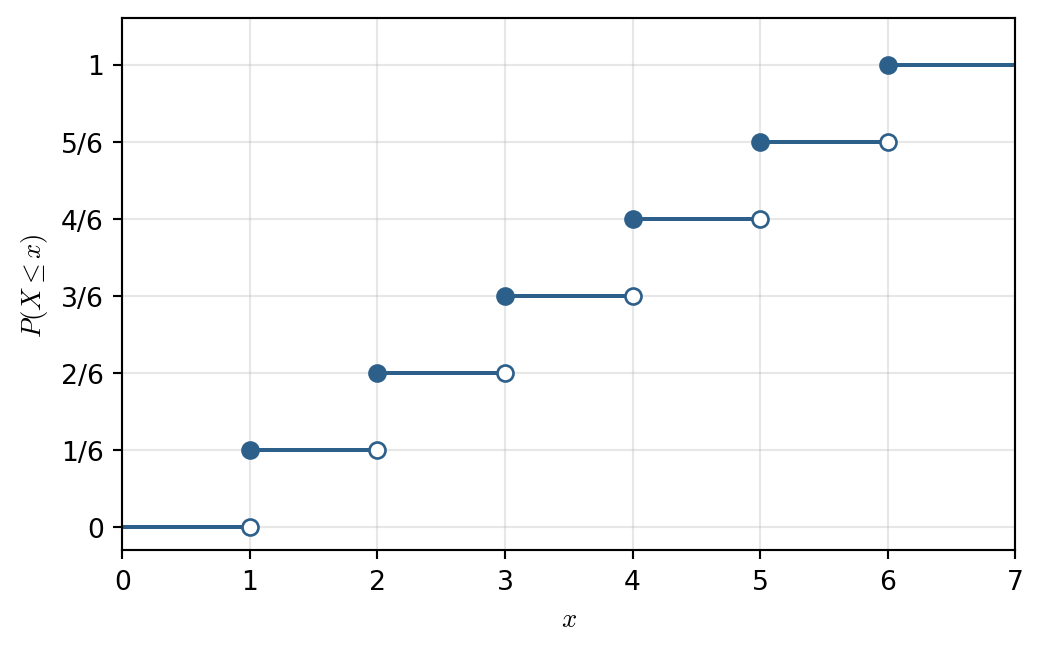
例えば,P(X \leq 3) を計算するには,次のようにする.
print(X.cdf(3))0.5D.2 連続型確率変数
確率密度関数(probability density function; PDF)は,連続型確率変数が特定の値を取る確率密度を表す関数であり,f(x) と書く.
連続型確率変数の場合,特定の値を取る確率は 0 であるため,確率密度関数を用いて区間の確率を計算する.例えば,P(a \leq X \leq b) は次のように計算される.
P(a \leq X \leq b) = \int_{a}^{b} f(x) \, dx
scipy.stats モジュールを用いて,様々な連続型確率変数を定義できる.
ここでは,X \sim N(0, 1) として,X を標準正規分布に従う確率変数とする.
from scipy.stats import norm

X = norm(loc=0, scale=1)
この確率変数 X の確率密度関数を 図 D.3 に示す.
コード
import numpy as np
import matplotlib.pyplot as plt

x = np.linspace(-4, 4, 1000)
y = X.pdf(x)

plt.figure(figsize=(6, 3.6))
plt.plot(x, y, color="#2c5f8a")
plt.xlabel("$x$")
plt.ylabel("$f(x)$")
plt.ylim(0, 0.45)
plt.grid(alpha=0.3)
plt.show()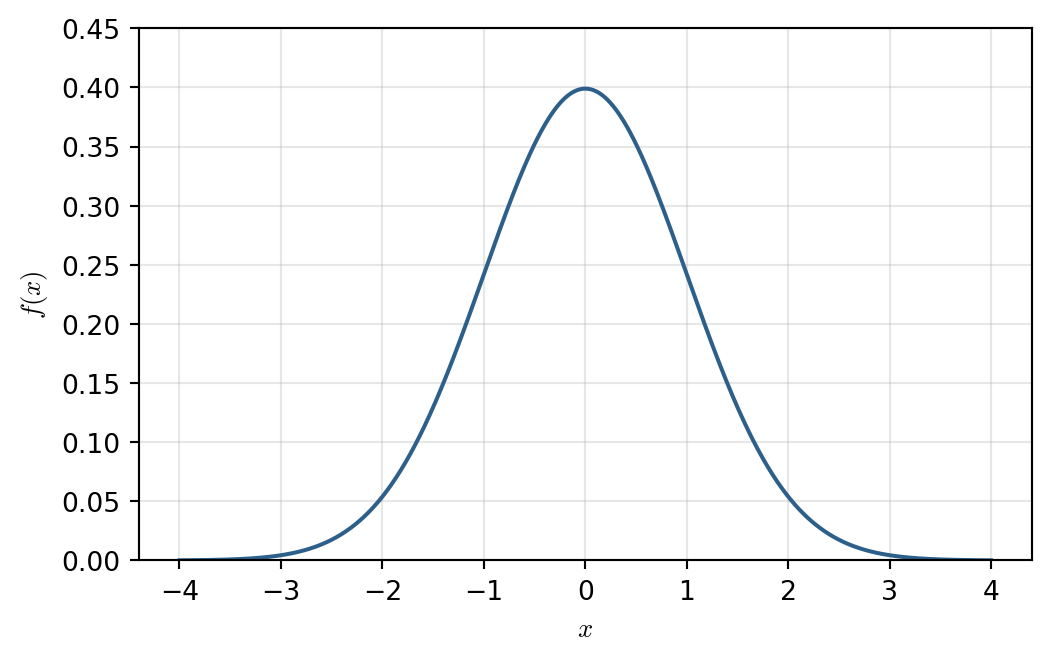
標準正規分布の累積分布関数を \Phi(x) = P(X \leq x) と書く.例えば,P(X \leq 1.96) は次のように計算される.
print(X.cdf(1.96))0.9750021048517795この確率は,図 D.4 の塗りつぶした部分の面積にあたる.
コード
# 確率密度関数と P(X <= 1.96) にあたる面積
x = np.linspace(-4, 4, 1000)
y = X.pdf(x)
prob = X.cdf(1.96)

plt.figure(figsize=(6, 3.6))
plt.plot(x, y, color="#2c5f8a")
plt.fill_between(x, 0, y, where=(x <= 1.96), color="#2c5f8a", alpha=0.2)
plt.axvline(1.96, color="#5b6b7c", linestyle="--")
plt.text(2.05, 0.4, "$x = 1.96$", fontsize=12)
plt.text(0, 0.12, f"$P(X \\leq 1.96) \\approx {prob:.3f}$", fontsize=12, ha="center")
plt.xlabel("$x$")
plt.ylabel("$f(x)$")
plt.ylim(0, 0.45)
plt.grid(alpha=0.3)
plt.show()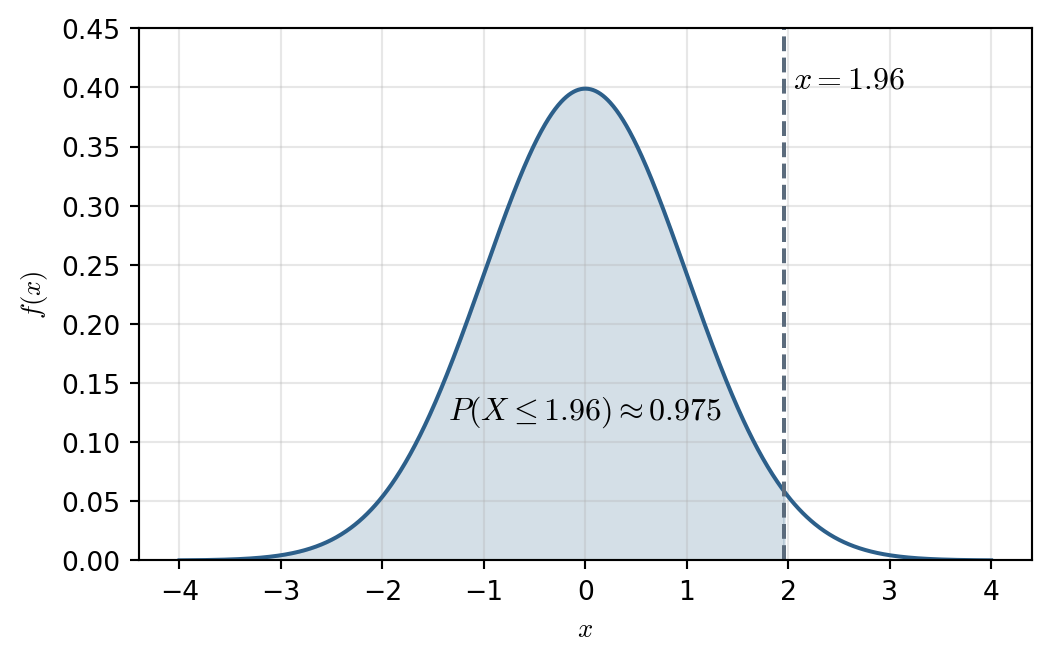
標準正規分布の累積分布関数を 図 D.5 に示す.
コード
y_cdf = X.cdf(x)

plt.figure(figsize=(6, 3.6))
plt.plot(x, y_cdf, color="#2c5f8a")
plt.xlabel("$x$")
plt.ylabel("$P(X \\leq x)$")
plt.ylim(-0.05, 1.05)
plt.grid(alpha=0.3)
plt.show()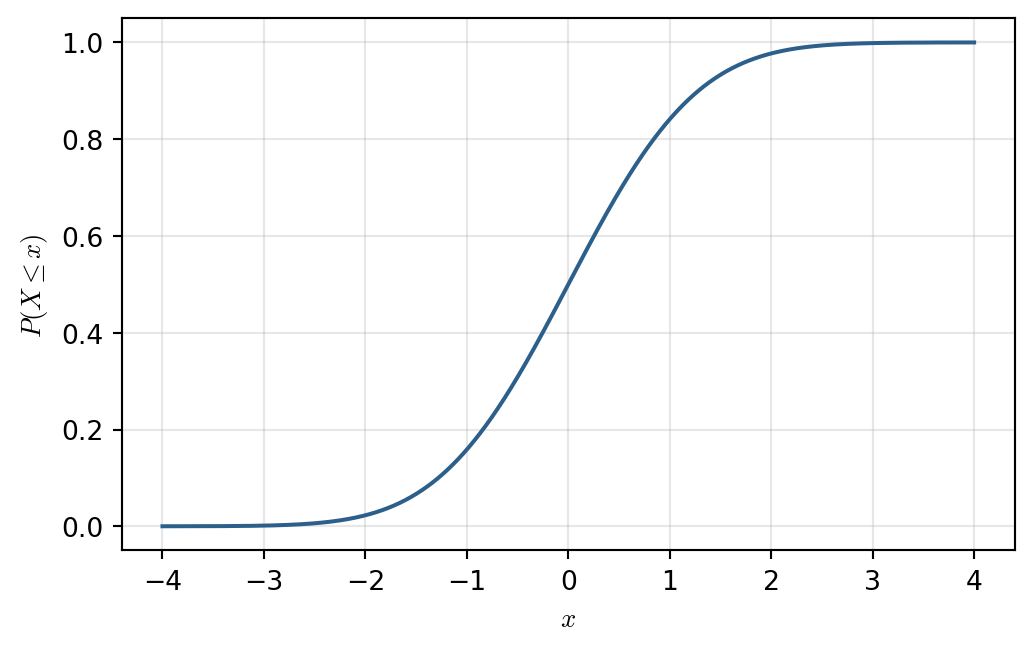
P(-1 \leq X \leq 1) は次のように計算される.
P(-1 \leq X \leq 1) = \Phi(1) - \Phi(-1)
Python では次のように計算する.
print(X.cdf(1) - X.cdf(-1))0.6826894921370859D.3 母集団と標本
統計の調査対象の全体を母集団(population)といい,母集団の一部を標本(sample)という.標本はサンプルとも呼ばれる.標本の大きさを標本サイズ(sample size)といい,一般に n で表される.
X \sim N(0, 1) からサンプルを 1000 個生成するには,rvs() メソッドを用いる.random_state に NumPy の乱数生成器 rng を渡すことで,シードを指定してサンプルを生成できる.
X = norm(loc=0, scale=1)
rng = np.random.default_rng(0)
samples = X.rvs(size=1000, random_state=rng)
これらのサンプルのヒストグラムを 図 D.6 に示す.
コード
x = np.linspace(-4, 4, 1000)
y = X.pdf(x)

plt.figure(figsize=(6, 3.6))
plt.hist(samples, bins=20, density=True, color="#2c5f8a", alpha=0.3, edgecolor="white")
plt.plot(x, y, color="#b03535")
plt.xlabel("$x$")
plt.ylabel("Density")
plt.grid(axis="y", alpha=0.3)
plt.show()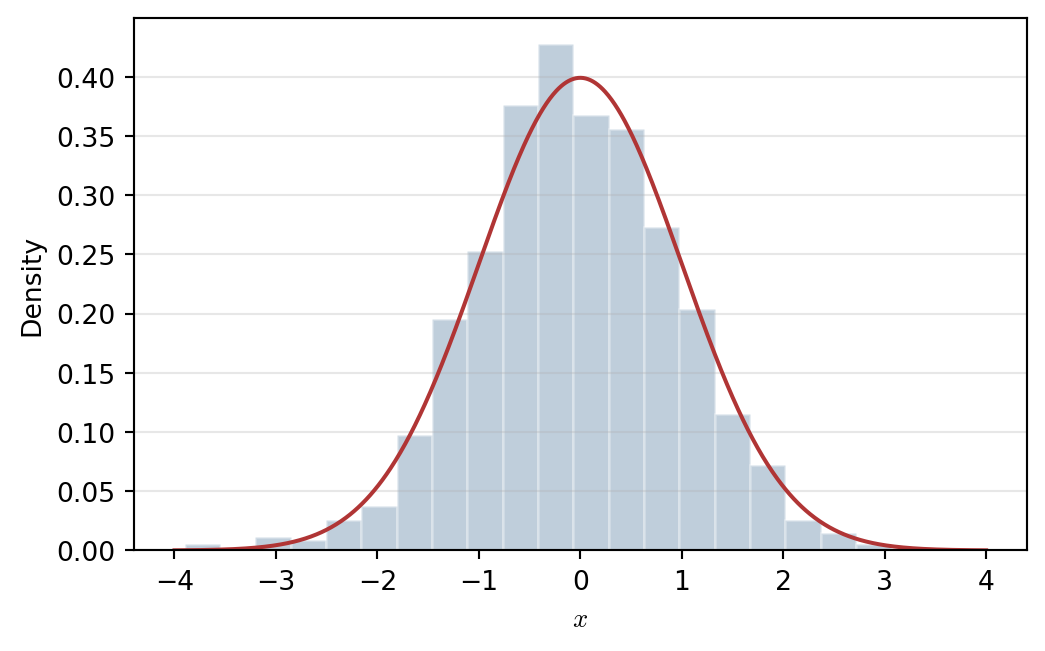
D.4 練習問題
練習 D.1 表が出ることを 1,裏が出ることを 0 とする.X をコイン投げの結果を表す確率変数とすると,X は 1 または 0 の値を取り,表が出る確率は P(X=1)=0.5,裏が出る確率は P(X=0)=0.5 である.確率変数 X の確率質量関数を scipy.stats モジュールを用いて定義し,表が出る確率 P(X=1) を計算せよ.
練習 D.2 標準正規分布に従う確率変数 X \sim N(0, 1) の累積分布関数を scipy.stats モジュールを用いて定義し,以下の確率を計算せよ.
- P(X \leq 0)
- P(X \leq 1.96)
- P(-1 \leq X \leq 1)
練習 D.3 正規分布に従う確率変数 Y \sim N(10, 2^2) の累積分布関数を scipy.stats モジュールを用いて定義し,以下の確率を計算せよ.
- P(Y \leq 8)
- P(Y \leq 12)
- P(8 \leq Y \leq 12)