前章では,グラフを使ってデータの特徴を調べた.本章では,データを一つの値で要約する方法を学ぶ.
データの中心や,よく現れる値を表す統計量を代表値という.代表値には,平均値,中央値,最頻値などがある.何を知りたいかによって,使う代表値を考えることが大切である.全国の市区町村の人口を使った分析は,チャプター 9 で扱う.
8 月の最高気温
東京の 8 月は,どのくらい暑かったのだろうか.セクション 5.3 で使った 2025 年の日ごとの最高気温を,一つの値で表すことを考えよう.まずは 8 月 1 日から 7 日までの 7 日分で計算方法を確かめ,その後,8 月全体の 31 日分を調べる.
tokyo_daily.csv をダウンロードし,前章と同じ手順で Colab にアップロードする.このファイルは,気象庁の観測データを加工したものである.本章では,最高気温の列 temp_max_c を使い,観測値の小数第 1 位をそのまま残して計算する.本章のコードは,上から順に実行する.
import pandas as pd

daily = pd.read_csv("tokyo_daily.csv")
august = daily[daily["month"] == 8]
august[["date", "temp_max_c"]].head(7)
| 212 |
2025-08-01 |
30.1 |
| 213 |
2025-08-02 |
35.1 |
| 214 |
2025-08-03 |
36.1 |
| 215 |
2025-08-04 |
36.1 |
| 216 |
2025-08-05 |
36.6 |
| 217 |
2025-08-06 |
37.0 |
| 218 |
2025-08-07 |
32.8 |
データは日付の順に並んでいる.最高気温の列を取り出し,最初の 7 日分に week_max という名前を付ける.取り出した列は,pandas の Series である.
week_max = august["temp_max_c"].head(7)
この 7 日間について,三つの問いを考えてみよう.
| 日最高気温は,平均すると何℃か |
平均値 |
| 最高気温を低い順に並べたとき,中央の値は何℃か |
中央値 |
| 最も多く記録された最高気温は何℃か |
最頻値 |
ここで求める「日最高気温の平均値」は,毎日の最高気温を平均した値である.一日の平均気温を平均した「月平均気温」とは異なる.
平均値
平均値(mean)は,データの合計をデータの個数で割った値である.
n 個のデータ x_1, x_2, \ldots, x_n の平均値を \bar{x} と書くと,次の式で表せる.\bar{x} は「エックスバー」と読む.
\bar{x} = \frac{x_1 + x_2 + \cdots + x_n}{n} = \frac{1}{n} \sum_{i=1}^{n} x_i
\sum_{i=1}^{n} x_i は,x_1 から x_n までを足すことを表す.
例 6.1 8 月 1 日から 7 日までの最高気温は,日付の順に 30.1,35.1,36.1,36.1,36.6,37.0,32.8℃ である.平均値は次のようになる.
\bar{x} = \frac{30.1 + 35.1 + 36.1 + 36.1 + 36.6 + 37.0 + 32.8}{7}
= \frac{243.8}{7} \approx 34.8
この 7 日間の日最高気温は,平均すると約 34.8℃ だったことになる.これは,毎日の最高気温が 34.8℃ だったという意味ではない.
Python では,Series の .mean() を使って平均値を計算できる.
mean_week_max = week_max.mean()
print("7日間の平均値(℃):", round(mean_week_max, 1))
round(値, 1) は,結果を小数第 1 位までに丸めて表示するために使っている.計算に使った元の観測値は変更していない.
平均値は,すべてのデータの値を使って計算する.そのため,一つの値が変わるだけでも,平均値は変化する.
調べたい対象全体を母集団,そこから取り出した一部を標本という.母集団の平均値を母平均,標本の平均値を標本平均と呼び,一般に母平均には \mu,標本平均には \bar{x} を使う.どちらも,対象となるデータの合計を個数で割って計算する.ただし,母集団のデータをすべて集められることは少ないため,母平均は標本平均から推定することが多い.本章では,手元にあるデータを要約することに注目する.
中央値
中央値(median)は,データを小さい順に並べたとき,中央の位置にある値である.データの個数が奇数か偶数かによって,求め方が異なる.
データの個数が奇数の場合
最初の 7 日分の最高気温を小さい順に並べると,次のようになる.単位は℃である.
30.1,\ 32.8,\ 35.1,\ \boxed{36.1},\ 36.1,\ 36.6,\ 37.0
中央は 4 番目なので,中央値は 36.1℃ である.
Python では,Series の .median() を使う.
median_week_max = week_max.median()
print("7日間の中央値(℃):", median_week_max)
データの個数が偶数の場合
8 月 8 日の最高気温 35.0℃ を加え,最初の 8 日分を小さい順に並べてみよう.
30.1,\ 32.8,\ 35.0,\ \boxed{35.1},\ \boxed{36.1},\ 36.1,\ 36.6,\ 37.0
中央に位置する値が二つあるため,その平均を中央値とする.この場合は,(35.1 + 36.1) / 2 = 35.6℃ である.中央値が,元のデータに含まれるとは限らない.
.head(8) で最初の 8 日分を取り出して確かめよう.
eight_days_max = august["temp_max_c"].head(8)
print("8日間の中央値(℃):", eight_days_max.median())
最頻値
最頻値(mode)は,データの中で最も多く現れる値である.モードとも呼ばれる.
最初の 7 日分の最高気温では,36.1℃ が 2 回現れ,ほかの値はそれぞれ 1 回ずつ現れる.したがって,最頻値は 36.1℃ である.最も多く現れる値ではあるが,7 日間の大半がこの気温だったわけではない.
Python では,Series の .mode() を使う.
print("7日間の最頻値(℃):")
print(week_max.mode())
7日間の最頻値(℃):
0    36.1
Name: temp_max_c, dtype: float64
.mean() や .median() と異なり,.mode() は結果を Series で返す.最頻値が一つとは限らないためである.この例の出力では,左側の 0 はインデックスであり,右側の 36.1 が最頻値である.
最頻値が複数ある場合
例えば,架空の 5 日間の最高気温が,28.0,28.0,30.0,30.0,31.0℃ だったとする.28.0℃ と 30.0℃ がともに 2 回現れるので,どちらも最頻値である.pd.Series() を使うと,リストから直接 Series を作れる.
example_max = pd.Series([28.0, 28.0, 30.0, 30.0, 31.0])
print(example_max.mode())
0    28.0
1    30.0
dtype: float64
カテゴリの最頻値
最頻値は,天気のようなカテゴリのデータにも使える.例えば,架空の 5 日間の天気を次のように記録したとする.
weather = pd.Series(["晴れ", "曇り", "晴れ", "雨", "晴れ"])
print(weather.mode())
最頻値は,3 回現れる「晴れ」である.天気の名前には数値としての大小や差がないため,平均値を計算することはできないが,最も多く現れる天気は答えられる.
8 月全体の代表値を調べる
ここまでは少数のデータで計算方法を確かめた.次に,8 月全体の 31 日分を使って,平均値,中央値,最頻値を求めよう.
august_max = august["temp_max_c"]
mean_august_max = august_max.mean()
median_august_max = august_max.median()

print("日数:", len(august_max))
print("平均値(℃):", round(mean_august_max, 1))
print("中央値(℃):", median_august_max)
print("最頻値(℃):")
print(august_max.mode())
日数: 31
平均値(℃): 34.4
中央値(℃): 35.1
最頻値(℃):
0    35.1
Name: temp_max_c, dtype: float64
平均値は約 34.4℃,中央値は 35.1℃,最頻値も 35.1℃ となる.35.1℃ が記録されたのは 3 日である.最頻値は,ここで使った小数第 1 位までの記録について求めた値であり,気温を整数に丸めるなど,値のまとめ方を変えると結果も変わることがある.
グラフで確かめる
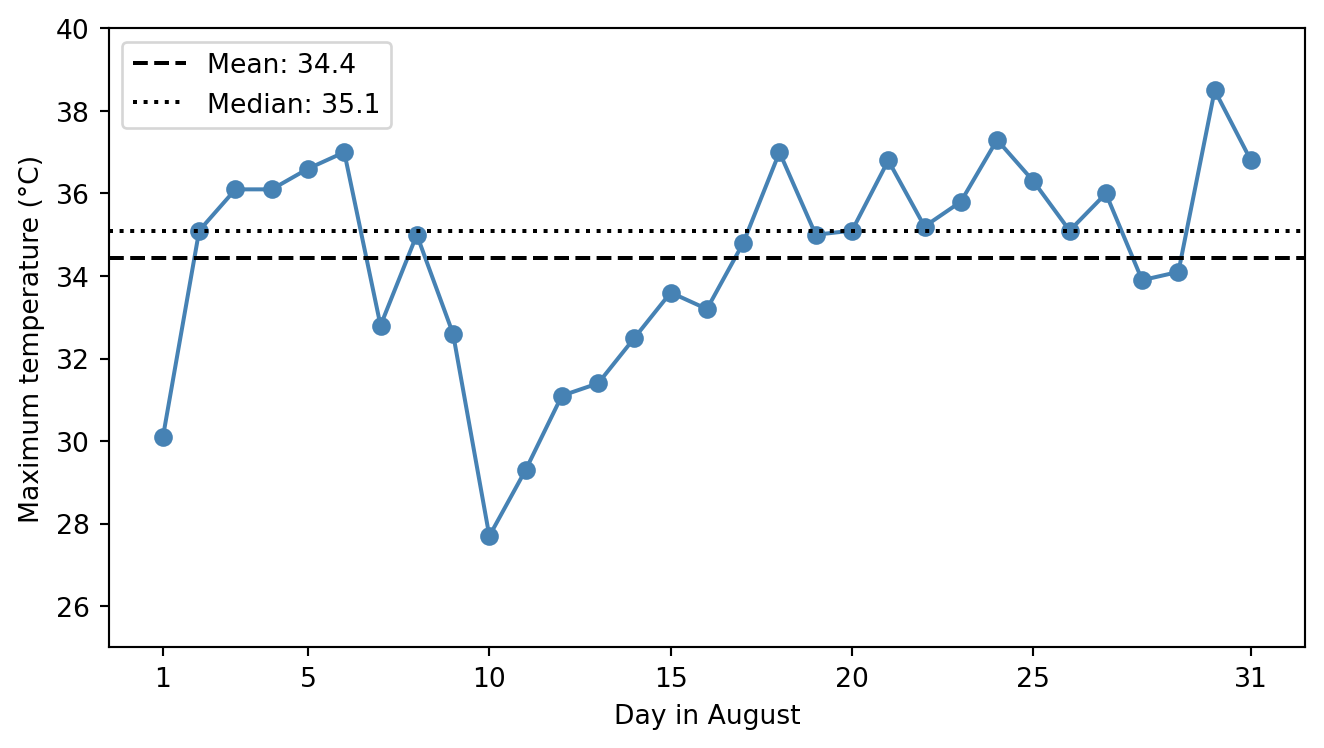
日ごとの最高気温を折れ線グラフにし,平均値と中央値を水平線で示してみよう.前章で使った plt.axhline() で線を引ける.
import matplotlib.pyplot as plt

plt.figure(figsize=(7, 4))
plt.plot(range(1, 32), august_max, marker="o", color="steelblue")
plt.axhline(mean_august_max, color="black", linestyle="--", label="Mean: 34.4")
plt.axhline(median_august_max, color="black", linestyle=":", label="Median: 35.1")
plt.xlabel("Day in August")
plt.ylabel("Maximum temperature (°C)")
plt.xticks([1, 5, 10, 15, 20, 25, 31])
plt.ylim(25, 40)
plt.legend()
plt.tight_layout()
plt.show()
図 6.1 では,最高気温が日によって変わり,27.7℃ の日も 38.5℃ の日もあったことがわかる.代表値で全体を要約するとともに,グラフで個々の値を確認することも大切である.
平均値と中央値の比較
一つの大きな値が変わったら
8 月全体の平均値と中央値の差は約 0.7℃ だった.ここでは,一つの大きな値の影響を確かめるため,昼食代の簡単な例を考えよう.次の値は,ある学生の 7 日間の昼食代を表す架空のデータであり,単位は円である.
最後の日の昼食代が 2100 円から 3500 円に変わったとすると,平均値と中央値はどう変わるだろうか.実行する前に予想してみよう.
lunch_cost = pd.Series([500, 700, 400, 600, 500, 800, 2100])
more_expensive_lunch = pd.Series([500, 700, 400, 600, 500, 800, 3500])

print("変更前の平均値(円):", lunch_cost.mean())
print("変更後の平均値(円):", more_expensive_lunch.mean())
print("変更前の中央値(円):", lunch_cost.median())
print("変更後の中央値(円):", more_expensive_lunch.median())
変更前の平均値(円): 800.0
変更後の平均値(円): 1000.0
変更前の中央値(円): 600.0
変更後の中央値(円): 600.0
最後の日の昼食代を 2100 円から 3500 円に変えると,合計は 1400 円増える.平均値は 1400 / 7 = 200 円増えて,800 円から 1000 円になる.一方,中央の値は変わらず,中央値は 600 円のままである.
このように,平均値は一部の非常に大きな値や小さな値の影響を受けやすい.中央値は値の順序と中央の位置に注目するため,少数の極端な値の影響を受けにくい.ただし,平均値にも用途がある.例えば,この 7 日間の昼食代の合計は,平均値に 7 を掛けると求められる.何を知りたいかに合わせて代表値を選ぼう.
ほかの統計では
平均値が一部の大きな値に引き上げられることは,ほかの統計でもよく起こる.
例 6.2 (世帯の貯蓄現在高) 総務省統計局の家計調査では,世帯が持つ預貯金や生命保険(払い込んだ掛金の総額),株式などの合計額を「貯蓄現在高」として調べている.2025 年の二人以上の世帯について,貯蓄現在高の平均値と中央値は次のとおりである.どちらも,貯蓄現在高が 0 の世帯を含めて計算した値である.
平均値は中央値より約 900 万円大きい.貯蓄現在高の少ない世帯が多い一方で,非常に多くの貯蓄を持つ世帯が一部にあり,それらの値が平均値を引き上げているためである.実際,平均値を下回る世帯は 66.1% と,約 3 分の 2 を占める.平均値だけを見て,多くの世帯が 2000 万円ほどの貯蓄を持っていると考えるのは誤りである.
出典:総務省統計局,家計調査報告(貯蓄・負債編)2025 年平均結果の概要.中央値の 1167 万円は,資料に参考値として示されている値である.資料で主に示されている「貯蓄保有世帯の中央値」1264 万円は,貯蓄現在高が 0 の世帯を除いて計算した値である.
貯蓄や所得のように,一部に非常に大きな値を含むデータでは,平均値と中央値の両方を確認しよう.
練習問題
練習 6.1 (9 月の最高気温を調べる) 同じ daily から,9 月の最高気温を取り出す.
september = daily[daily["month"] == 9]
september_max = september["temp_max_c"]
- 日数を確認し,平均値,中央値,最頻値を求めよ.最頻値はすべて答えること.
- 最高気温を小さい順に並べたとき,中央値は何番目と何番目の値から求められるか.
- 平均値と中央値を使って,8 月と 9 月の日最高気温の違いを説明せよ.ここで求めた平均値は,月平均気温と同じものか.
まとめ
- 平均値は合計を個数で割った値であり,すべての値の影響を受ける.
- 中央値は小さい順に並べたときの中央を表し,少数の極端な値の影響を受けにくい.
- 最頻値は最も多く現れる値である.複数ある場合もあり,カテゴリのデータにも使える.
- pandas の Series では,
.mean(),.median(),.mode() で代表値を求められる.
- 何を知りたいかに合わせて代表値を選び,グラフも使ってデータの分布を確認する.
8 月の日最高気温の中央値は 35.1℃ だったが,代表値だけでは,日ごとの値がどのくらい散らばっているかはわからない.次章では,同じ 31 日分の気温を使い,中央値から四分位数へと考え方を広げ,データのばらつきを学ぶ.