前章で学んだ平均値や中央値は,データの中心を表す.しかし,中心が同じでも,値がその近くに集まっている場合と,広く散らばっている場合がある.
本章では,まず四分位数と四分位範囲を学び,箱ひげ図でデータの中心とばらつきを確認する.その後,ばらつきを表す別の指標である分散と標準偏差を学ぶ.
四分位数と四分位範囲
中央値から四分位数へ
チャプター 6
\begin{gathered}
27.7,\ 29.3,\ 30.1,\ 31.1,\ 31.4,\ 32.5,\ 32.6,\ 32.8, \\
33.2,\ 33.6,\ 33.9,\ 34.1,\ 34.8,\ 35.0,\ 35.0,\ 35.1, \\
35.1,\ 35.1,\ 35.2,\ 35.8,\ 36.0,\ 36.1,\ 36.1,\ 36.3, \\
36.6,\ 36.8,\ 36.8,\ 37.0,\ 37.0,\ 37.3,\ 38.5
\end{gathered}
データが 31 個なので,中央値は 16 番目の値である.この場合,35.1℃ となる.
中央値は,小さい順に並べたデータの中央の位置を表す.さらに,およそ 4 分の 1 と 4 分の 3 の位置にも注目すると,中央付近の値がどの範囲に集まっているかを捉えられる.このように,データを四つに分ける位置を表す値を四分位数 という.
第 1 四分位数
Q_1 25% の位置
第 2 四分位数
Q_2 50% の位置(中央値)
第 3 四分位数
Q_3 75% の位置
この例では,Q_1=33.0 ℃,Q_2=35.1 ℃,Q_3=36.2 ℃ となる.1 番目の値の位置を 0%,31 番目の値の位置を 100% と考えると,25% の位置は 1+30\times0.25=8.5 番目,つまり 8 番目と 9 番目の値のちょうど中間にあたる.そこで,Q_1 は 8 番目と 9 番目の値の平均 (32.8+33.2)/2=33.0 とする.同じように,75% の位置は 1+30\times0.75=23.5 番目なので,Q_3 は 23 番目と 24 番目の値の平均 (36.1+36.3)/2=36.2 となる.50% の位置は 1+30\times0.5=16 番目であり,中央値と一致する.
Python では,np.percentile() を使って計算できる.第 2 引数に,小さい方から何%の位置を求めるかを指定する.ここでは,セクション 5.3 tokyo_daily.csv を読み込み,month が 8 の行から最高気温の列を取り出す.
import numpy as npimport pandas as pd= pd.read_csv("tokyo_daily.csv" )= daily[daily["month" ] == 8 ]= august["temp_max_c" ]= np.percentile(august_max, 25 )= np.percentile(august_max, 50 )= np.percentile(august_max, 75 )print ("第1四分位数:" , q1)print ("中央値:" , median)print ("第3四分位数:" , q3)
第1四分位数: 33.0
中央値: 35.1
第3四分位数: 36.2
四分位数には複数の計算方法があり,教科書やソフトウェアによって結果が少し異なる場合がある.例えば,中学校・高校の数学で学ぶように,中央値を除いた前半 15 個と後半 15 個のそれぞれの中央値を Q_1 ,Q_3 とすると,この例では Q_1=32.8 ℃,Q_3=36.3 ℃ となる.本章では,NumPy の percentile() の標準の計算方法(method="linear")を使う.以下の Matplotlib の箱ひげ図も,同じ方法で四分位数を計算する.
四分位範囲でばらつきを表す
第 3 四分位数から第 1 四分位数を引いた値を,四分位範囲 (interquartile range,IQR)という.
\mathrm{IQR}=Q_3-Q_1
四分位範囲は,中央のおよそ半分のデータが集まる範囲の幅を表す.この値が大きいほど,中央付近のデータが広く散らばっている.
8 月の例では,Q_1=33.0 ℃ から Q_3=36.2 ℃ までの幅なので,四分位範囲は 36.2-33.0=3.2 ℃ となる.
= q3 - q1print ("四分位範囲:" , round (iqr, 1 ))
小数の計算では,コンピュータの内部でわずかな誤差が生じることがある.q3 - q1 をそのまま表示すると 3.200000000000003 となるため,round(値, 1) で小数第 1 位までに丸めて表示した.
箱ひげ図
箱ひげ図 (box plot)は,中央値と四分位数を使って,データの中心とばらつきを表すグラフである.複数のグループを並べると,分布の違いを比べやすい.
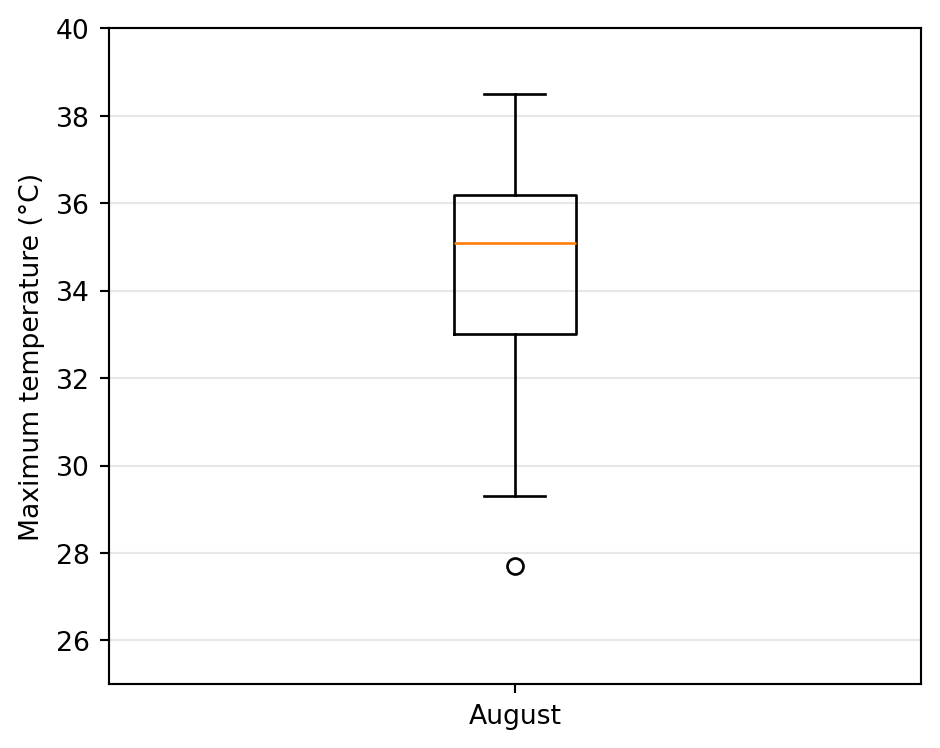
ここでは,縦向きの箱ひげ図を使う.箱の下端が第 1 四分位数 Q_1 ,上端が第 3 四分位数 Q_3 ,箱の中の線が中央値を表す.したがって,箱の高さは四分位範囲に等しい.
ひげと,ひげの外にある点
箱の上下に伸びる線を「ひげ」という.Matplotlib の標準設定では,次の範囲に入る観測値のうち,最小の値と最大の値までひげを伸ばす.
Q_1-1.5\times\mathrm{IQR}
\quad\text{から}\quad
Q_3+1.5\times\mathrm{IQR}
この範囲の外にある値は,個別の点で表示される.そのため,ひげの端がデータ全体の最小値や最大値になるとは限らない.
8 月の例では,この範囲は 33.0-1.5\times3.2=28.2 ℃ から 36.2+1.5\times3.2=41.0 ℃ までである.範囲内の観測値の最小値は 29.3℃,最大値は 38.5℃ なので,ひげの端は 29.3℃ と 38.5℃ になる.27.7℃ は範囲外なので,個別の点で表示される.28.2℃ と 41.0℃ は判定のための境界であり,ひげの端そのものではない.
import matplotlib.pyplot as plt= (5 , 4 ))= ["August" ])"Maximum temperature (°C)" )25 , 40 )= "y" , alpha= 0.3 )
plt.boxplot() にデータを渡すと,四分位数などを計算して箱ひげ図を描く.tick_labels は,各グループの名前を指定する引数である.複数のグループを一つの図に並べるには,plt.boxplot([データ1, データ2], tick_labels=["名前1", "名前2"]) のように,データと名前をそれぞれリストにまとめて渡す.
図 7.1 から,中央付近の最高気温は 33.0℃ から 36.2℃ の範囲にあり,27.7℃ の日もあったことがわかる.また,中央値が 35.1℃ なので,8 月の半分以上の日は,最高気温が 35℃ 以上の猛暑日だったこともわかる.
ひげの外の点は,ほかの値から離れた外れ値の候補 を示している.点で表示されたという理由だけで,誤った記録と決めたり,削除したりしてはいけない.例えば,最高気温が 27.7℃ だった 8 月 10 日には 25.5 mm の雨が降っており,雨で気温が上がらなかったのかもしれない.
箱ひげ図のひげの描き方は,設定によって変わる.他の資料の図を読むときも,どの規則で描かれているかを確認しよう.Matplotlib の設定は,boxplot() の公式ドキュメント
練習 7.1 daily から,次のように 4 月と 10 月の最高気温を取り出す.
= daily[daily["month" ] == 4 ]= daily[daily["month" ] == 10 ]= april["temp_max_c" ]= october["temp_max_c" ]
4 月と 10 月の最高気温を,同じ図に箱ひげ図で示せ.
中央値と四分位範囲を比較せよ.
ひげの外にある点にも注目し,中央値だけではわからない違いを説明せよ.
四分位範囲は,中央付近のデータのばらつきに注目する指標である.次に,すべての観測値と平均値との差を使う分散を学ぼう.
分散
平均値が同じでも,データのばらつきが同じとは限らない.ここでは,各データと平均値との差に注目して,ばらつきを数値で表す方法を考える.
平均値との差を使う
例 7.1
1 人目
1
3
2 人目
1
3
3 人目
5
3
4 人目
5
3
平均待ち時間はどちらも 3 分である.しかし,窓口 A では 1 分待った人と 5 分待った人がいるのに対して,窓口 B では全員が 3 分待っている.
平均値からどのくらい離れているかを調べるため,各データから平均値を引く.窓口 A では -2, -2, 2, 2 ,窓口 B では 0, 0, 0, 0 となる.窓口 A の差をそのまま足すと,正と負が打ち消し合って 0 になる.そこで,差を二乗してから平均する.この値を分散 (variance)という.
窓口 A の分散は
\frac{(1-3)^2 + (1-3)^2 + (5-3)^2 + (5-3)^2}{4} = 4
となり,窓口 B の分散は
\frac{(3-3)^2 + (3-3)^2 + (3-3)^2 + (3-3)^2}{4} = 0
となる.元のデータの単位が分なので,分散の単位は分^2 である.窓口 A の分散は 4 分^2 ,窓口 B の分散は 0 分^2 となる.この 4 人ずつの記録では,窓口 A の待ち時間にはばらつきがあり,窓口 B の待ち時間にはばらつきがない.
分散の計算式
n 個のデータ x_1, x_2, \ldots, x_n の平均値を \bar{x} とすると,分散は次の式で計算できる.本書では,分母を n とするこの分散を標本分散 と呼び,s_n^2 で表す.
s_n^2 = \frac{(x_1 - \bar{x})^2 + (x_2 - \bar{x})^2 + \cdots + (x_n - \bar{x})^2}{n} = \frac{1}{n} \sum_{i=1}^{n} (x_i - \bar{x})^2
計算の手順は,「平均値を引く」「二乗する」「平均する」の三つである.分散は 0 以上の値を取り,すべての値が同じときに 0 になる.平均値からの離れ方を二乗した値の平均が大きいほど,分散は大きくなる.
標準偏差
例 7.1 では,待ち時間の単位が分であるのに対して,分散の単位は分^2 となった.元のデータと同じ単位でばらつきを表すために,分散の平方根を取る.これを標準偏差 (standard deviation)という.
s_n = \sqrt{s_n^2} = \sqrt{\frac{1}{n} \sum_{i=1}^{n} (x_i - \bar{x})^2}
窓口 A の標準偏差は \sqrt{4}=2 分,窓口 B の標準偏差は \sqrt{0}=0 分である.標準偏差を使うと,待ち時間のばらつきを分という元の単位で表せる.
Python で計算する
分散は np.var(),標準偏差は np.std() で計算できる.ここでは,記録した 4 人ずつの待ち時間のばらつきを記述するため,分母を n とする ddof=0 を指定する.ddof を省略した場合も,これらの関数では ddof=0 となる.
= np.array([1 , 1 , 5 , 5 ])= np.array([3 , 3 , 3 , 3 ])= np.var(a_wait, ddof= 0 )= np.var(b_wait, ddof= 0 )= np.std(a_wait, ddof= 0 )= np.std(b_wait, ddof= 0 )print ("窓口 A の分散(分²):" , a_variance)print ("窓口 B の分散(分²):" , b_variance)print ("窓口 A の標準偏差(分):" , a_std)print ("窓口 B の標準偏差(分):" , b_std)
窓口 A の分散(分²): 4.0
窓口 B の分散(分²): 0.0
窓口 A の標準偏差(分): 2.0
窓口 B の標準偏差(分): 0.0
調べたい対象全体を母集団 ,そこから取り出した一部を標本 という.手元のデータのばらつきを記述する場合と,標本から母集団の分散(母分散 )を推定する場合では,分散の計算を使い分ける.
母集団から独立に無作為抽出したと考えると,分母が n の標本分散は,抽出と計算を繰り返したときの平均が母分散より小さくなる.そこで,母分散の推定には,分母を n-1 にした不偏分散 を使う.データの個数は n \ge 2 とする.
s^2 = \frac{1}{n-1} \sum_{i=1}^{n} (x_i - \bar{x})^2
「不偏」とは,抽出と計算を繰り返したときの平均が,推定したい母分散に一致することをいう.一度の計算で母分散と一致するという意味ではない.
NumPy では,np.var(data, ddof=1) で不偏分散を計算できる.ddof は分母の n から引く値を指定する引数であり,ddof=0 なら分母は n ,ddof=1 なら n-1 となる.
np.std(data, ddof=1) は,不偏分散の平方根を計算する.これは母集団の標準偏差の推定によく使われるが,標準偏差の不偏推定量ではない.本書では,これも「標準偏差」と呼び,ddof の値を明記する.なお,「標本分散」という名前を,分母が n-1 の分散に使う資料もあるため,式や設定を確認しよう.
練習問題
練習 7.2
import numpy as np= np.array([70 , 80 , 90 , 100 , 60 , 75 , 85 , 95 , 65 , 55 ])# ここにコードを書け
練習 7.3 data というリストを引数として受け取り,そのデータの標本分散を計算して返す関数 my_variance() を定義せよ.
import numpy as npdef my_variance(data):# ここにコードを書く return variance= [1 , 2 , 3 , 4 , 5 ]= my_variance(data)print ("分散:" , variance)print ("確認:" , np.var(data, ddof= 0 ))