これまでは,代表値やばらつきを使って,一つの変数の特徴を調べてきた.本章では,二つの変数の関係に注目する.
例えば,最高気温が高い日は,最低気温も高いのだろうか.前章と同じ東京の 8 月のデータを使い,まず散布図で関係を見る.その後,共分散と相関係数を使って,関係を数値で表す方法を学ぶ.
最高気温と最低気温
チャプター 6
tokyo_daily.csv をダウンロードし,チャプター 4
import pandas as pdimport matplotlib.pyplot as plt= pd.read_csv("tokyo_daily.csv" )= daily[daily["month" ] == 8 ]"date" , "temp_max_c" , "temp_min_c" ]].head(7 )
212
2025-08-01
30.1
23.8
213
2025-08-02
35.1
24.9
214
2025-08-03
36.1
26.2
215
2025-08-04
36.1
27.7
216
2025-08-05
36.6
28.3
217
2025-08-06
37.0
28.1
218
2025-08-07
32.8
27.3
1 行が 1 日を表し,temp_max_c が最高気温,temp_min_c が最低気温である.どちらも単位は℃である.例えば,8 月 1 日は最高気温が 30.1℃,最低気温が 23.8℃ なので,この二つを一組として扱う.
= august["temp_max_c" ]= august["temp_min_c" ]
二つの変数の関係を調べるには,同じ対象について測った値を組にする ことが大切である.ここでは,同じ日の最高気温と最低気温を対応させる.それぞれの列を別々に並べ替え,行の対応を無視して順番だけで組にすると,異なる日の値を比べることになってしまう.
散布図で関係を見る
散布図 (scatter plot)は,二つの数値変数を横軸と縦軸に取り,一組のデータを一つの点で表すグラフである.
例 8.1 plt.scatter() の第 1 引数に横軸のデータ,第 2 引数に縦軸のデータを渡す.
= (6 , 4 ))"Maximum temperature (°C)" )"Minimum temperature (°C)" )= 0.3 )
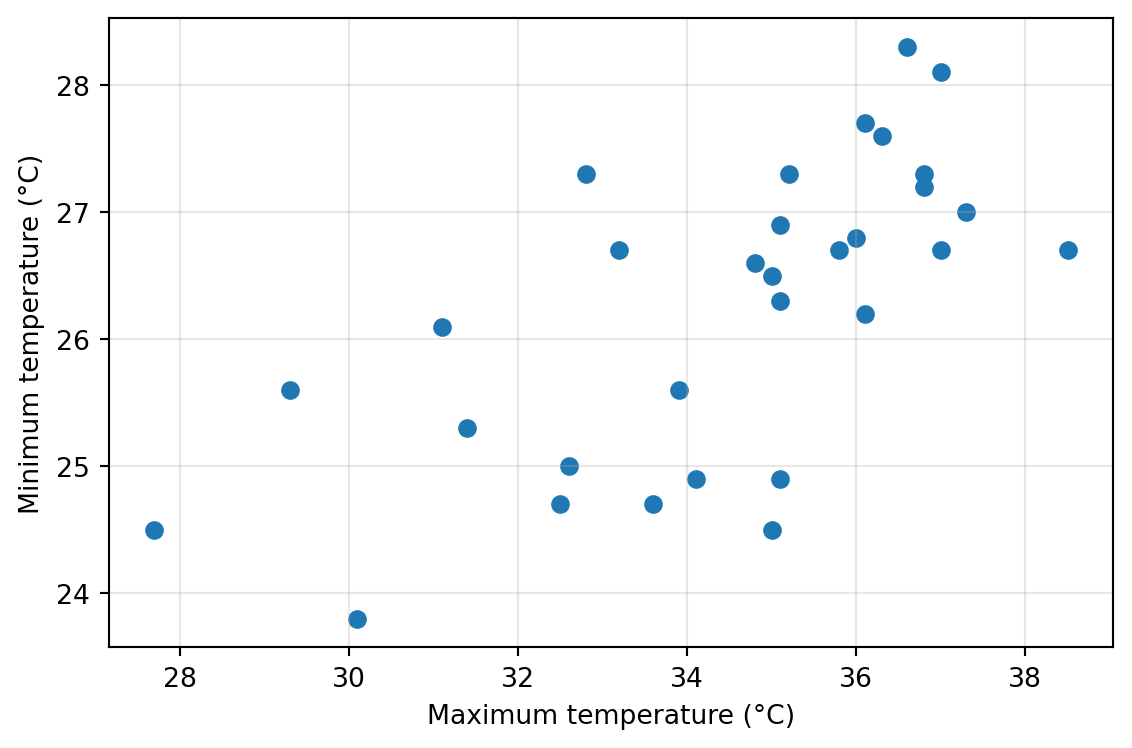
図 8.1 では,点が全体として右上がりに分布している.この 31 日間では,最高気温が高い日ほど,最低気温も高い傾向がある.ただし,点は一直線に並んでいるわけではなく,最高気温が近くても最低気温が異なる日がある.
一方の値が大きいほど,もう一方も大きい傾向を正の相関 ,一方の値が大きいほど,もう一方が小さい傾向を負の相関 という.
全体として右上がり
正の相関がある
全体として右下がり
負の相関がある
右上がり・右下がりの傾向がはっきりしない
直線的な関係が弱い可能性がある
相関は全体の傾向を表すものであり,すべての点がその傾向に従うとは限らない.また,点が曲線状に並ぶこともあるため,直線的な傾向だけでなく,分布の形も確かめよう.
共分散
前章の分散では,各データと平均値との差を二乗した.二つの変数の関係を調べるときは,それぞれの平均との差を掛け合わせてみよう.
差の積の符号
最高気温を x ,最低気温を y とし,それぞれの平均値を \bar{x} ,\bar{y} と書く.次のコードで平均値を求めると,最高気温は約 34.4℃,最低気温は約 26.2℃ となる.
= august_max.mean()= august_min.mean()print ("最高気温の平均値(℃):" , round (mean_max, 1 ))print ("最低気温の平均値(℃):" , round (mean_min, 1 ))
最高気温の平均値(℃): 34.4
最低気温の平均値(℃): 26.2
両方が平均値より高い日は,差の積 (x-\bar{x})(y-\bar{y}) が正になる.両方が平均値より低い日も,負の数どうしを掛けるので,積は正になる.それに対し,一方が平均値より高く,もう一方が低い日は,積が負になる.
平均値より高い
平均値より高い
正
平均値より低い
平均値より低い
正
平均値より高い
平均値より低い
負
平均値より低い
平均値より高い
負
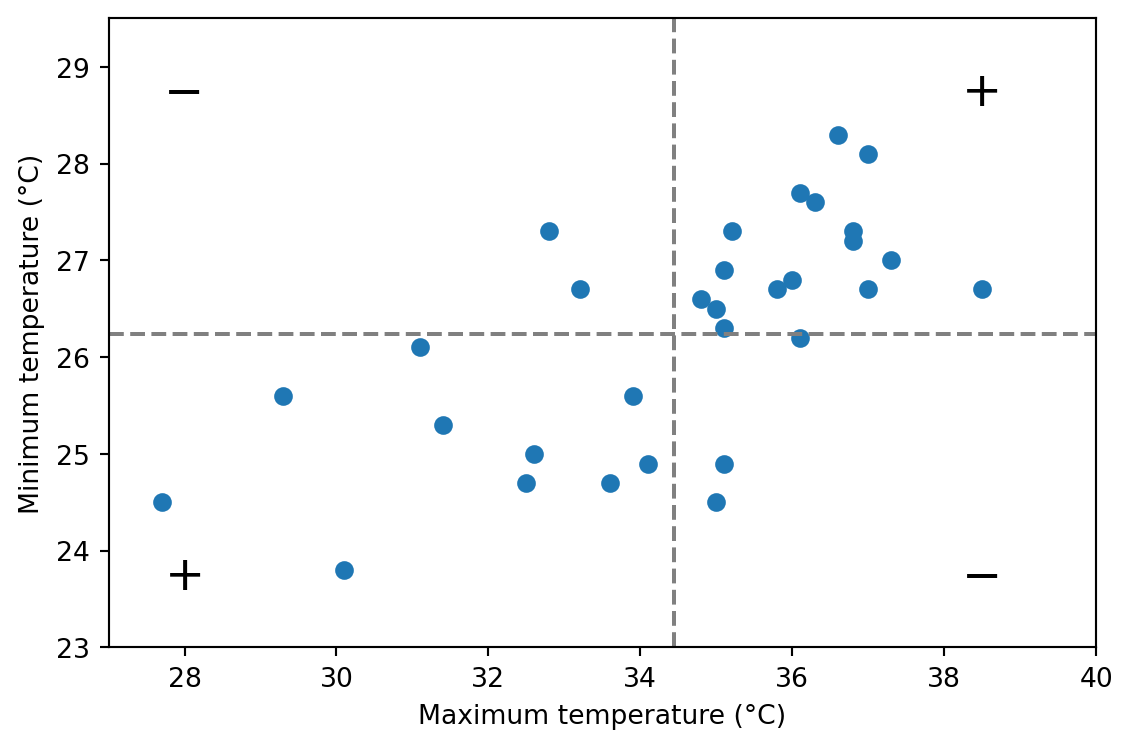
どちらかの値が平均値と等しいとき,積は 0 になる.散布図に二つの平均値の線を加えると,この符号を確かめられる.
コード
= (6 , 4 ))= "gray" , linestyle= "--" )= "gray" , linestyle= "--" )38.5 , 28.6 , "+" , fontsize= 18 , ha= "center" )28.0 , 23.6 , "+" , fontsize= 18 , ha= "center" )28.0 , 28.6 , "−" , fontsize= 18 , ha= "center" )38.5 , 23.6 , "−" , fontsize= 18 , ha= "center" )27 , 40 )23 , 29.5 )"Maximum temperature (°C)" )"Minimum temperature (°C)" )
例えば,8 月 1 日の点 (30.1, 23.8) は左下,8 月 6 日の点 (37.0, 28.1) は右上の領域にある.どちらも差の積は正である.図 8.2 のように,正の積の合計が負の積の絶対値の合計を上回ると,積の平均は正になる.単に点の個数を比べるのではなく,平均値からの離れ方も含めて考えている.
共分散
それぞれの平均との差の積を平均した値を,共分散 (covariance)という.n 組のデータ (x_1,y_1),\ldots,(x_n,y_n) に対し,本章では分母を n とする共分散を s_{xy,n} と書く.前章で扱った,分母が n の標本分散と同じ考え方である.
s_{xy,n}=\frac{1}{n}\sum_{i=1}^{n}(x_i-\bar{x})(y_i-\bar{y})
計算の手順は,「それぞれの平均値を引く」「対応する差を掛ける」「積を平均する」の三つである.
= august_max - mean_max= august_min - mean_min= (max_deviation * min_deviation).mean()print ("共分散(℃²):" , round (covariance, 2 ))
august_max - mean_max のように,Series から一つの数値を引くと,各要素からその数値が引かれる.+,*,/,** でも同じように要素ごとに計算され,NumPy 配列でも同様である.また,max_deviation * min_deviation では,同じ日の差どうしが掛けられる.
共分散は約 1.91℃^2 となり,正の値である.これは,散布図で見た右上がりの傾向と対応している.分散と異なり,共分散は負になることもある.
ただし,共分散の大きさは単位に依存する.例えば,身長と体重の共分散では,身長を m から cm に直すだけで,身長の平均値も平均との差も 100 倍になり,共分散も 100 倍になる.このため,共分散の値だけでは,異なる単位の変数どうしの関係の強さを比べにくい.
相関係数
共分散を二つの変数の標準偏差の積で割ると,単位の影響を取り除ける.この値を相関係数 (correlation coefficient)という.本章で扱うものは,ピアソンの相関係数 とも呼ばれ,二つの変数の直線的な関係の向きと強さ を表す.
前章と同様に,分母が n の分散から求めた標準偏差を s_{x,n} ,s_{y,n} とすると,相関係数 r は次のようになる.
r=\frac{s_{xy,n}}{s_{x,n}s_{y,n}}
=\frac{\sum_{i=1}^{n}(x_i-\bar{x})(y_i-\bar{y})}
{\sqrt{\sum_{i=1}^{n}(x_i-\bar{x})^2}\sqrt{\sum_{i=1}^{n}(y_i-\bar{y})^2}}
気温の例では,共分散の単位は℃^2 ,標準偏差の積の単位も℃^2 なので,割り算によって単位がなくなる.
Series の .corr() を使うと,相関係数を直接求められる.一方の Series に対し,もう一方を引数として渡す.
= august_max.corr(august_min)print ("8月の相関係数:" , round (r_august, 2 ))
相関係数は約 0.66 である.この 31 日間には,最高気温が高い日ほど最低気温も高いという,正の相関がある.0.66 は,最低気温が最高気温の 66% になるという意味でも,66% の日で両方の気温が高かったという意味でもない.
共分散と標準偏差から計算しても,同じ値になる.
= august_max.std(ddof= 0 )= august_min.std(ddof= 0 )= covariance / (std_max * std_min)print ("共分散と標準偏差から計算:" , round (r_from_covariance, 2 ))
pandas の .std() は,省略時には ddof=1,つまり分母が n-1 の分散の平方根を計算する.上のコードでは,分母が n の共分散に合わせて ddof=0 を指定した.共分散と二つの分散の分母をすべて n-1 にそろえても,相関係数ではその係数が打ち消し合うため,結果は同じになる.
pandas の .corr() は,二つの Series の行ラベル(インデックス)を対応させて計算する.同じ表から二つの列を取り出すと,元の行の対応を保ちやすい.どちらかの値が欠けている組は,計算から除かれる.本章の 8 月の二つの気温には欠損値がなく,31 組すべてを使っている.
後の章で使う NumPy の np.corrcoef(x, y)[0, 1] でも,同じ相関係数を求められる.np.corrcoef() は二つの変数の相関を表にした 2 行 2 列の配列を返し,[0, 1] で 1 行目・2 列目の値を取り出す.
import numpy as npprint ("NumPyで確認:" , round (np.corrcoef(august_max, august_min)[0 , 1 ], 2 ))
相関係数の読み方
相関係数は -1\le r\le1 の範囲の値を取る.符号が関係の向き,絶対値が直線的な関係の強さを表す.
r が 1 に近い強い正の相関がある
r が -1 に近い強い負の相関がある
r が 0 に近い直線的な関係が弱い
例えば,r=-0.9 は r=0.3 より直線的な関係が強い.負だから弱いというわけではない.また,r=1 ならすべての点が右上がりの直線上に,r=-1 なら右下がりの直線上に並ぶ.ただし,どちらかの変数の値がすべて同じ場合は,標準偏差が 0 になるため,相関係数を定義できない.
相関係数における注意点
非線形な関係
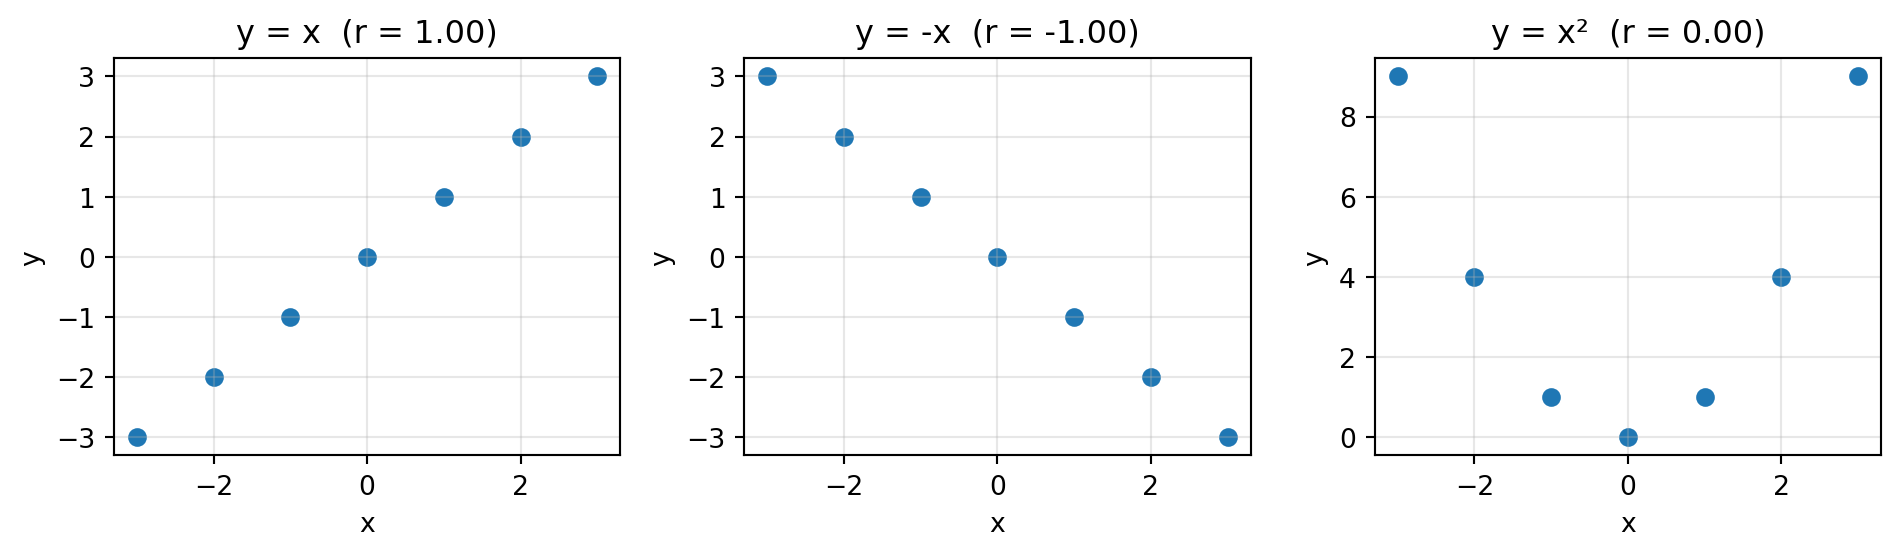
次の図は,説明のために作成した三つのデータである.左と中央では点が一直線に並んでいる.右では,y=x^2 という関係がある.
コード
= pd.Series([- 3 , - 2 , - 1 , 0 , 1 , 2 , 3 ])= [x_example, - x_example, x_example ** 2 ]= ["y = x" , "y = -x" , "y = x²" ]= plt.subplots(1 , 3 , figsize= (10 , 3 ))for ax, y_example, title in zip (axes, y_examples, titles):= x_example.corr(y_example)f" { title} (r = { r:.2f} )" )"x" )"y" )= 0.3 )
図 8.3 の右の図は,相関係数が 0 でも,二つの変数の間に関係がある例である.相関係数は直線的な関係を表すため,曲線状の関係を十分に捉えられない.また,少数の極端な点に影響されることもある.相関係数と散布図を合わせて確認しよう.
相関関係と因果関係
二つの変数に相関があっても,一方が他方の原因であるとは限らない.例えば,暑い日ほどアイスクリームも冷たい飲み物もよく売れるとしよう.両方の売上に正の相関があっても,それだけで「アイスクリームが売れるから,冷たい飲み物も売れる」とはいえない.気温という別の要因が,両方に関係している可能性がある.
同じように,最高気温と最低気温に正の相関があることだけから,一方が他方を高くするとは結論できない.相関係数では横軸と縦軸を入れ替えても値は同じであり,原因と結果の向きはわからない.原因を考えるには,ほかの要因や時間の前後関係,データを集めた方法も調べる必要がある.
練習問題
練習 8.1 (9 月の気温の関係を調べる) daily から,9 月の最高気温と最低気温を取り出す.
= daily[daily["month" ] == 9 ]= september["temp_max_c" ]= september["temp_min_c" ]
最高気温を横軸,最低気温を縦軸とする散布図を描け.軸名と単位も付けること.
相関係数を求め,8 月の結果と比べよ.
この結果から読み取れる傾向を一文で説明せよ.また,相関係数だけでは判断できないことを一つ挙げよ.
練習 8.2 (アヤメの大きさを調べる) setosa_sepal_length はがく片の長さ,setosa_sepal_width はがく片の幅であり,単位はどちらも cm である.
from sklearn.datasets import load_iris= load_iris(as_frame= True )= iris.data[iris.target == 0 ]= setosa["sepal length (cm)" ]= setosa["sepal width (cm)" ]
長さを横軸,幅を縦軸とする散布図を描き,相関係数を求めよ.
長さだけを mm に直し,相関係数をもう一度求めよ.元の値と比べ,その理由を説明せよ.
練習 8.3 (相関係数を自分で計算する(発展)) x,y を受け取り,相関係数を返す関数 my_corrcoef() を定義せよ.それぞれの配列には 2 個以上の数値があり,欠損値はなく,どちらもすべて同じ値ではないものとする.
それぞれの平均値を引いた配列を作る.
差の積の合計を求める.
差の二乗の合計をそれぞれ求め,相関係数の式に代入する.平方根は np.sqrt() で求められる.
def my_corrcoef(x, y):# ここにコードを書く return r= np.array([- 3 , - 2 , - 1 , 0 , 1 , 2 , 3 ])y = x,y = -x,y = x ** 2 の三つの場合を調べ,np.corrcoef(x, y)[0, 1] と結果が一致することを確かめよ.
まとめ
散布図では,同じ対象から得た二つの値を一つの点として表す.
共分散は,それぞれの平均との差の積を平均した値である.正にも負にもなり,単位に依存する.
相関係数は,共分散を二つの標準偏差の積で割った値であり,単位をもたない.pandas では .corr() で求められる.
相関係数の符号は直線的な関係の向き,絶対値はその強さを表す.0 に近くても,曲線状の関係があるかもしれない.
相関関係だけでは因果関係は判断できない.散布図や,データを集めた条件も合わせて考える.
ここまでで,データを読み込み,グラフと数値で特徴を調べる方法を学んだ.次章からは,これらを組み合わせて実際の問いを考える.気温とさくらの開花日の関係は,チャプター 10